RAG-Systeme: KI-Antworten aus Ihren eigenen Dokumenten
Verbinden Sie PDFs, Verträge, Handbücher, Netzlaufwerke und Wiki mit einem KI-Assistenten. Er antwortet in klarer Sprache und nennt Dokument und Seite, auf die er sich stützt. Er läuft auf Ihrem eigenen Server, auf Wunsch offline, oder in einer deutschen Cloud. Ihre Daten bleiben unter Ihrer Kontrolle.
Warum ChatGPT Ihre Dateien nicht kennt
So funktioniert ein RAG-System
- RRetrieval: finden
- Das System findet die Passagen in Ihren Quellen, die am besten zur Frage passen.
- AAugmented: übergeben
- Diese Passagen werden der Frage mitgegeben, und zwar nur aus Dokumenten, die die fragende Person sehen darf.
- GGeneration: antworten
- Ein Sprachmodell formuliert daraus die Antwort und nennt Dokument und Seite. Passt nichts, sagt es das, statt zu raten.
Technik im Detail: vom Dokument zur Vektordatenbank
Mit einem Anwendungsfall starten
Wählen Sie eine Frage, die in Ihrem Betrieb jede Woche gestellt wird. Stimmen diese Antworten, kommt die nächste dazu.
RAG-Datenquellen
Hosting und Datenschutz (DSGVO)
- On-premise, offlineA server or workstation in your office, with open-source models running locally. Works without internet.
Am besten fürVerträge, Gesundheits- und Rechtsakten
- Private cloud in GermanyYour own server in a German data centre, used only by you. No hardware in the office.
Am besten fürTeams an mehreren Standorten
- Hosted AI modelDocuments stay indexed on your system. Only the question and the found passages go to the provider, in an EU region where offered.
Am besten fürDen schnellsten Start
DSGVO, Punkt für Punkt
Ein RAG-System liest Ihre Dokumente, und die enthalten oft personenbezogene Daten. Diese vier Punkte decken ab, was die DSGVO für die Einrichtung verlangt.
Technische Grundlage, keine Rechtsberatung. Das letzte Wort hat Ihr Datenschutzbeauftragter.
- Art. 28Auftragsverarbeitung
- Ein Vertrag zur Auftragsverarbeitung (AVV) mit jedem Anbieter, der personenbezogene Daten verarbeitet.
- Art. 17Löschen
- Wird ein Dokument in Ihrem System gelöscht, verschwindet es beim nächsten Abgleich auch aus dem Index.
- Art. 5Ihre Protokolle
- Fragen und Antworten werden nur protokolliert, wenn Sie es möchten, auf Ihrem eigenen System und so lange, wie Sie entscheiden.
- Art. 30Dokumentation
- Die Datenflüsse dokumentiert für Ihr Verzeichnis von Verarbeitungstätigkeiten, dazu eine Datenschutz-Folgenabschätzung (DSFA), wo sie nötig ist.
RAG-Pilotprojekt in 4 bis 6 Wochen
- Kostenloses ErstgesprächWelche Fragen sollen beantwortet werden, aus welchen Quellen?
- Anwendungsfall und PlanEin Anwendungsfall, seine Quellen und was als gute Antwort zählt.
- PilotprojektIhre Quellen in Ihrer Umgebung, getestet mit echten Fragen.
- Gemessenes ErgebnisWie oft die richtige Quelle kam, gemessen an Ihren Testfragen.
- Ausbau und BetreuungMehr Quellen und Nutzer, Schulung, neue Dokumente automatisch indexiert.
Languages and tools
The basics, chosen per project. myRAG below is one combination.
- Languages
- Python
- TypeScript
- Frameworks
- LangChain
- LlamaIndex
- Vector databases
- PostgreSQL with pgvector
- Qdrant
- Embedding models
- bge-m3
- OpenAI embeddings
- Language models
- Ollama (local)
- OpenAI
- Claude
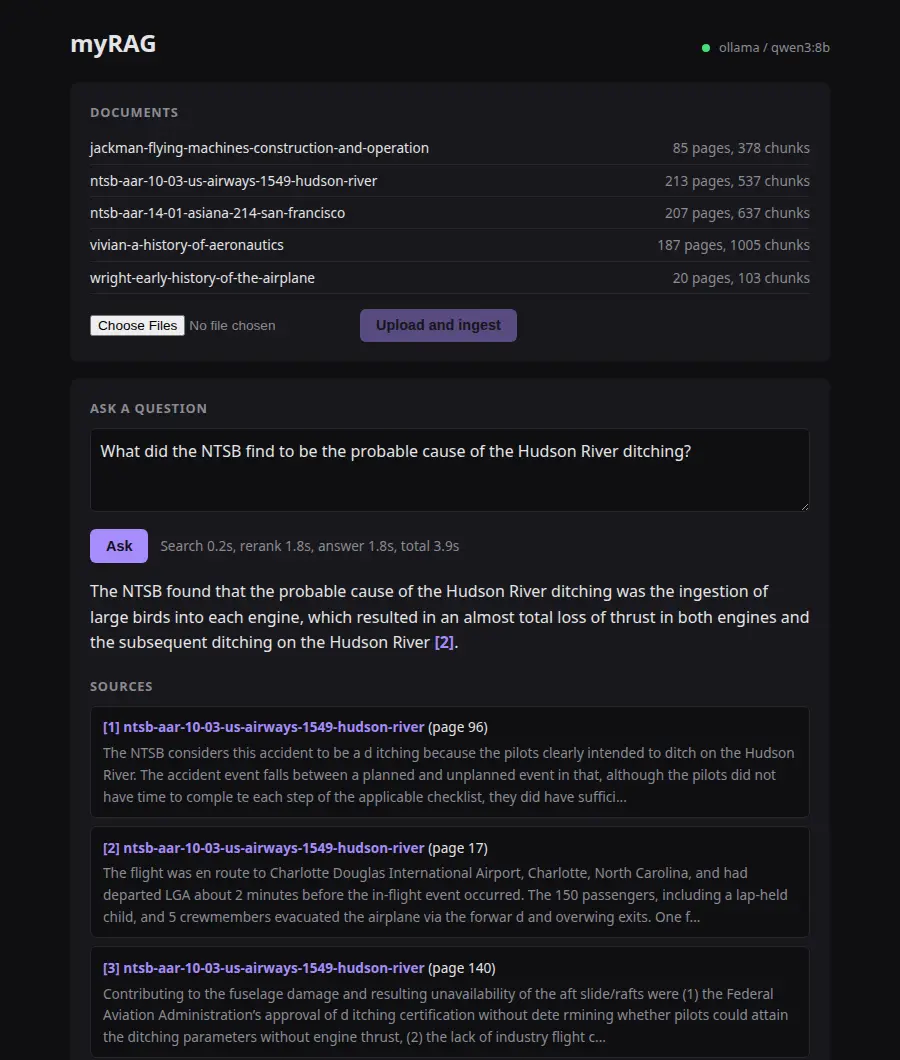
Demo: myRAG
- Was es ist
- Belambos eigener Open-Source-RAG-Assistent für PDF-Dokumente. Eine Demo, kein Kundenprojekt.
- Gemessen
- Die richtige Quelle unter den ersten fünf bei 85 % von 46 Testfragen; 98 % der Antworten stimmen mit der Quelle überein.
- Läuft auf
- Ein einziger Rechner: Python und FastAPI, PostgreSQL mit pgvector, bge-m3-Embeddings, Qwen3 über Ollama, neu gewichtet durch das Sprachmodell.
Häufige Fragen zu RAG
Was ist anders als bei ChatGPT mit hochgeladenen Dateien?
Uploads umfassen nur wenige Dateien auf einmal und verlassen Ihr Unternehmen. Ein RAG-System durchsucht alle Ihre Quellen auf einmal, beachtet Ihre Zugriffsrechte und kann auf Ihrem eigenen Server laufen.
Welche Hardware brauche ich für den Betrieb im eigenen Haus?
Für einen Betrieb meist eine Workstation oder ein kleiner Server mit moderner Grafikkarte. Die genaue Empfehlung steht im Angebot.
Gehen meine Daten an ChatGPT?
Nur wenn Sie das wählen. Standard sind Modelle mit Hosting in der EU oder auf eigenen Servern, entschieden je Projekt.
Speichert Belambo Daten von uns?
Nein. Belambo speichert keine Nutzerdaten aus Ihrem RAG-System. Dokumente, Suchindex, Fragen und etwaige Protokolle bleiben auf Ihrem Server oder in Ihrer eigenen Cloud, bei Ihren Administratoren.
Kontakt
Eine kurze Nachricht reicht.
Antwort innerhalb eines Werktags